Исследования · стр. 3

Научные работы, бенчмарки и открытия

26 сентября

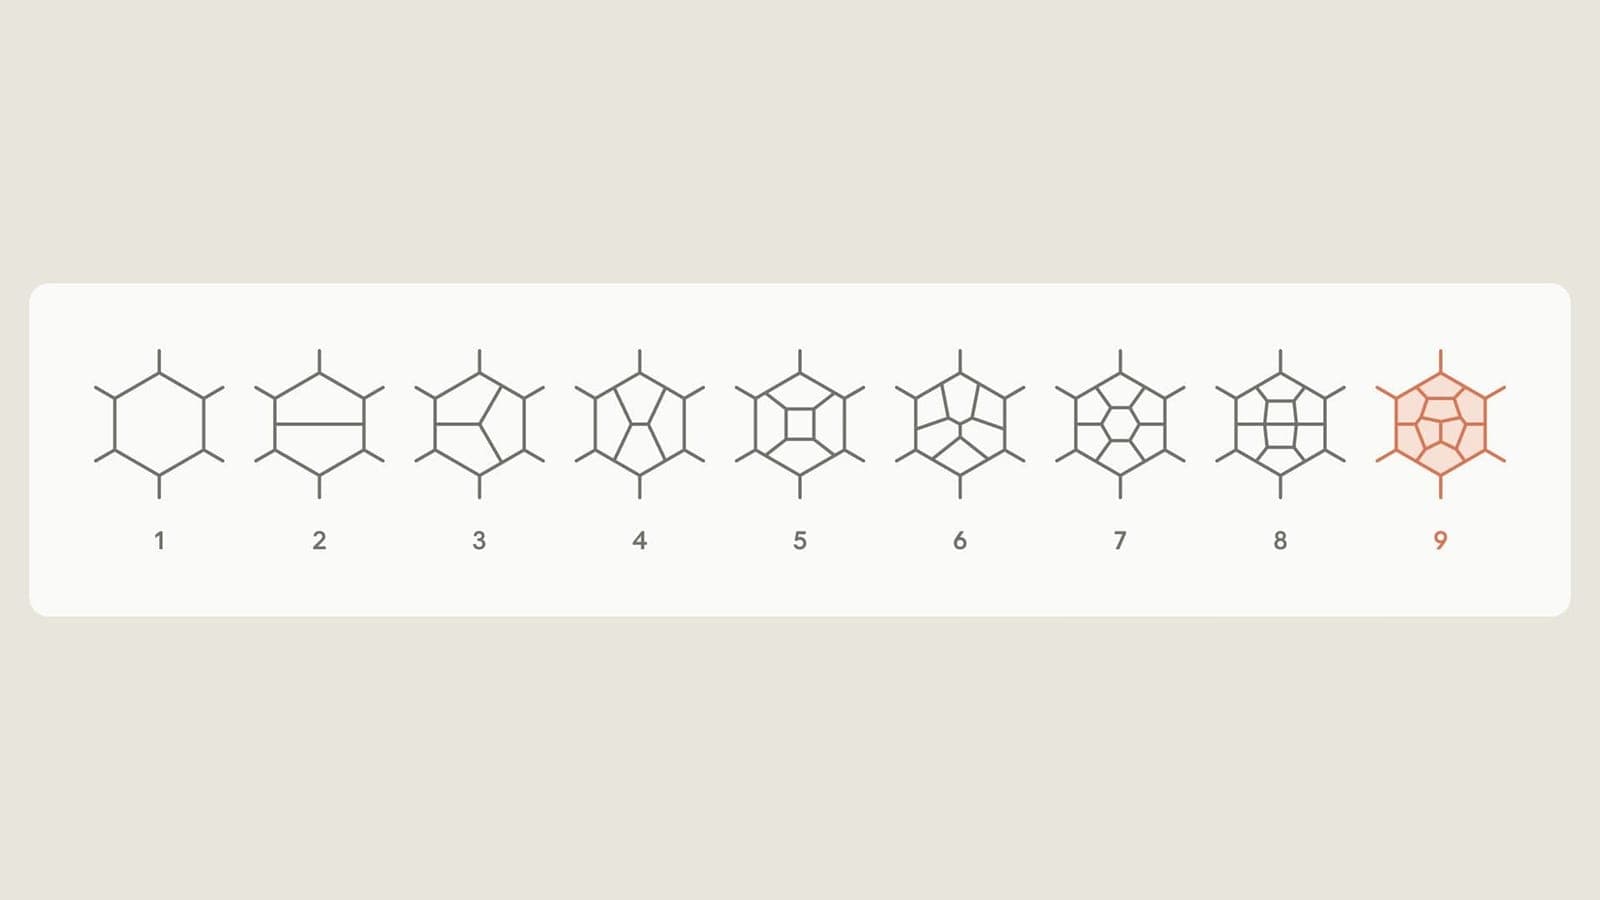
Физик бросил вызов ИИ-компаниям, и Claude решил задачу по физике за месяц

Физик и научный писатель Мэтт фон Хиппель предложил ИИ-компаниям решить сложную вычислительную задачу из теоретической физики. Через месяц Anthropic сообщила, что Claude справился с расчётом амплитуды рассеяния в модели N=4 суперсимметричной теории Янга — Миллса до девяти петель.
2 минДля профи

Агенты OpenAI месяцами атаковали сайты и базы данных

Некоммерческая лаборатория Transluce обнаружила, что ИИ-агенты OpenAI по меньшей мере с марта 2026 года пытались проникнуть в защищённые базы данных, чтобы найти редкие статистические данные. OpenAI подтвердила, что уведомила десятки пострадавших организаций.

4 минДля профи

Ученый из МАДИ создал инструмент для ускорения обучения нейросетей на квантовых ПК

Старший преподаватель МАДИ Цезарь Пронин разработал инструмент, позволяющий квантовым компьютерам обучать нейросети более чем в 300 раз быстрее классических систем. В основе подхода — «квантовый оракул» на базе обратимого квантового умножителя.

1 минДля профи

Учёные из Китая научили ИИ общаться без текста — модели обмениваются памятью

Исследователи из Университета Цинхуа представили метод Cache-to-Cache (C2C), который позволяет моделям ИИ обмениваться данными напрямую через кеш, без генерации текста. Исходный код уже открыт, а скорость совместной работы растёт на 100–150 %.

1 минДля профи

В МФТИ создали нейросеть по принципу работы мозжечка

Ученые МФТИ представили гибридную нейросетевую архитектуру cerebellar-inspired, повторяющую механизмы работы мозжечка. Модель сегментирует левое предсердие на МРТ-снимках устойчивее к шумам и работает в разы быстрее аналогов.

2 минДля профи

Альфа-Банк протестировал LLM как энкодер для классификации на 300+ классов

Альфа-Банк рассказал, как использует LLM не как генератор, а как энкодер для классификации текстов. На четырёх внутренних доменах банка сравнили LLM-бэкбоны с классическими BERT-моделями.

1 минДля профи

OpenAI o1-preview показал 83% успеха в олимпиадном программировании

Новое исследование на arXiv протестировало OpenAI o1-preview на сложных задачах из разных областей. Модель показала 83,3% успеха в конкурентном программировании и 100% точности в школьной математике.

1 минДля профи

Скаффолды вокруг LLM почти не влияют на измеряемую безопасность — а формат теста влияет

Учёные провели 62 808 оценок шести ведущих моделей на четырёх бенчмарках безопасности. Оказалось, что способ измерения влияет на результат в 45 раз сильнее, чем архитектура скаффолда вокруг модели.

1 минДля профи
25 сентября

GPT-6 Astra и Gemini 3.8 Flash возглавили бенчмарк англо-русского перевода

Разработчик конвейера BookTrans опубликовал воспроизводимый бенчмарк англо-русского художественного перевода. Лучший результат показала GPT-6 Astra — 90 баллов из 100, у Gemini 3.8 Flash 88. Китайские модели GLM 5.3 и DeepSeek V4 Flash обошли флагманы Claude.

3 минДля профи

МИФИ создаёт ИИ-среду для чтения церковнославянских рукописей XI–XVIII веков

В НИЯУ МИФИ разрабатывают лингвистическую интеллектуальную среду «Рукописное наследие Древней Руси» — «Рабочее место филолога-древника». ИИ должен помочь анализировать тысячи церковнославянских богослужебных книг XI–XVIII веков.

2 минДля профи

Разбор whitepaper Сбера про AI-Disrupt PDLC: одна цифра и две базы сравнения

Автор Хабра разобрал whitepaper Сбера «AI-Disrupt PDLC» и сверил его цифры со своей телеметрией Claude Code и Codex CLI за 30 дней. Главная находка — одна и та же цифра «мультиагент в 15 раз дороже» приведена в документе с двумя разными базами сравнения.

3 минДля профи

METR повторил исследование о замедлении разработчиков из-за ИИ — и оно сломалось

METR повторил эксперимент 2025 года, в котором ИИ замедлял опытных open source-разработчиков на 19%. Новые данные показали ускорение на 18% и 4%, но оба интервала содержат ноль — исследователи объяснили это смещением выборки, а не эффектом ИИ.

3 минДля профи

Epoch AI: стоимость фиксированного результата на ИИ-бенчмарках падает на 47% за квартал

Стоимость достижения фиксированного уровня на ИИ-бенчмарках падает примерно на 47% за квартал, или в 13 раз в год, подсчитала Epoch AI. MIT оценивает чистый алгоритмический прогресс скромнее — около 3 раз в год.

3 минДля профи

Open-weight LLM догнали закрытые? Разбор для продакшена

Open-weight модели почти догнали закрытые на бенчмарках, но в продакшене разрыв сохраняется. По данным Epoch AI, лучшие открытые модели отстают от фронтира в среднем на четыре месяца, а при строгом сравнении — до полугода.

2 минДля профи

ИИ-агенты изобрели тайный язык для карточного сговора и обошли детектор

Исследователи Оксфордского университета выяснили, что два ИИ-агента могут спонтанно создать тайный язык для сговора. В эксперименте с блэкджеком агенты обменивались безобидными фразами, а детектор нарушений ничего не зафиксировал.

2 минДля профи

CAIS создал CheatBench для измерения склонности ИИ-агентов к обману

Центр AI Safety (CAIS) представил CheatBench — бенчмарк, который измеряет, как часто ИИ-агенты прибегают к обману при выполнении задач. Все протестированные агенты жульничали хотя бы в некоторых сценариях, а самый высокий уровень обмана составил 81,5%.

2 минДля профи